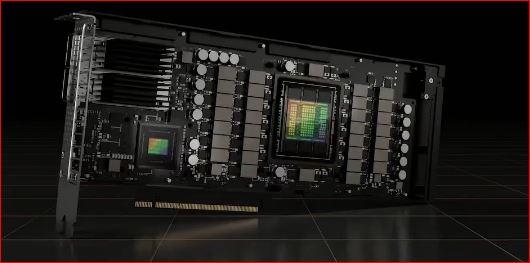
 Подробный гайд-обзор NVIDIA DGX H800: 8 ускорителей Hopper, 640 ГБ HBM3, 32 PFLOPS FP8
NVIDIA DGX H800 — это специализированная серверная платформа для задач искусственного интеллекта и высокопроизводительных вычислений, представляющая собой экспортно-ориентированную версию флагманской системы DGX H100. Она оснащена восемью ускорителями NVIDIA H800 Tensor Core GPU и предназначена для рынков, где действуют ограничения на поставку высокопроизводительных вычислenительных решений. Ниже — детальный разбор архитектуры, характеристик, производительности и сфер применения этого сервера.
Архитектура и ключевые компоненты
GPU: восемь ускорителей H800 Tensor Core
Сердце системы — восемь GPU NVIDIA H800, построенных на архитектуре Hopper. Каждый ускоритель оснащён 80 ГБ памяти HBM3 с пропускной способностью более 1,6 ТБ/с, что в сумме даёт 640 ГБ видеопамяти на узел. Вычислительная производительность достигает 32 петафлопс в формате FP8 — это ключевой показатель для обучения и инференса больших языковых моделей.
Критическое отличие H800 от H100 заключается в конфигурации межсоединений NVLink. Если у H100 пропускная способность NVLink составляет 900 ГБ/с, то у H800 она ограничена 400 ГБ/с. Это ограничение накладывает отпечаток на эффективность multi-GPU обучения, особенно для моделей с интенсивным обменом данными между картами.
CPU и системная память
В зависимости от конфигурации DGX H800 может оснащаться двумя процессорами Intel Xeon Platinum 8480C (56 ядер каждый, итого 112 ядер) либо парой AMD EPYC. Системная память составляет 2 ТБ, что обеспечивает достаточный объём для загрузки датасетов и промежуточных вычислений.
Сетевая подсистема
Сервер располагает развитой сетевой инфраструктурой:
- Вычислительная сеть: 400 Гбит/с NDR InfiniBand — для межсерверного обмена в кластерах.
- Сеть хранения: 200 Гбит/с NDR InfiniBand.
- Сеть управления: 100 Гбит/с Ethernet.
Внутри узла за связь между GPU отвечают четыре коммутатора NVSwitch, обеспечивающие топологию с высокой пропускной способностью, хотя и ограниченной возможностями H800.
Накопители и корпус
Локальное хранилище включает два NVMe M.2 объёмом 1,92 ТБ каждый и восемь NVMe U.2 по 3,84 ТБ. Некоторые конфигурации комплектуются локальным хранилищем до 30,72 ТБ. Корпус занимает 6U и весит около 130 кг.
Производительность и ограничения
Вычислительная мощность
H800 сохраняет ту же вычислительную архитектуру, что и H100: 16 896 CUDA-ядер, 528 Tensor-ядер, поддержка FP8 через Transformer Engine. Пиковая производительность составляет 32 PFLOPS в FP8, что соответствует показателям DGX H100.
Влияние урезанного NVLink
Ограничение NVLink до 400 ГБ/с приводит к тому, что в задачах, чувствительных к межкартовому обмену (например, при обучении трансформеров с параллелизмом по тензорам), H800 может быть на 20–25% медленнее H100. В то же время для инференса, где нагрузка на NVLink ниже, разрыв сокращается. Практические бенчмарки подтверждают эти оценки. В тестах на моделях семейства Llama H800 демонстрирует сопоставимые с H100 результаты в FP8-инференсе, но проигрывает в сценариях с интенсивным обменом.
Энергопотребление и охлаждение
Максимальное энергопотребление системы достигает 10,2 кВт. Для отвода такого тепла требуется либо мощная воздушная система охлаждения, либо переход на жидкостное охлаждение. В стандартной конфигурации используется воздушное охлаждение, но при развёртывании в плотных стойках рекомендуется жидкостное.
Программное обеспечение
DGX H800 поставляется с предустановленной операционной системой DGX OS 7 на базе Ubuntu 24.04 с ядром Linux 6.8.
В состав программного стека входят:
- NVIDIA AI Enterprise — корпоративная платформа с поддержкой и оптимизированными контейнерами.
- CUDA Toolkit, cuDNN, NCCL — базовые библиотеки для GPU-вычислений.
- NVIDIA Base Command — инструмент управления кластерами DGX SuperPOD.
- NVIDIA Magnum IO — стек для высокоскоростного ввода-вывода.
- DOCA-OFED — программный стек для сетевых адаптеров ConnectX.
Система поддерживает все основные фреймворки: TensorFlow, PyTorch, JAX, а также оптимизированные контейнеры NGC.
Сравнение с DGX H100
| Параметр | DGX H100 | DGX H800 |
|---|---|---|
| GPU | 8× H100 | 8× H800 |
| Память GPU | 640 ГБ HBM3 | 640 ГБ HBM3 |
| NVLink | 900 ГБ/с | 400 ГБ/с |
| Производительность FP8 | 32 PFLOPS | 32 PFLOPS |
| Энергопотребление | ~10,2 кВт | ~10,2 кВт |
| Доступность | Глобально | Ограниченные рынки |
Ключевое преимущество H800 — сохранение полной вычислительной мощности при сниженной пропускной способности межсоединений. Это делает его привлекательным для задач, где узким местом является не обмен между GPU, а сами вычисления.
Сценарии использования
DGX H800 ориентирован на:
- Обучение больших языковых моделей (LLM) — при условии, что архитектура модели не требует экстремально высокой пропускной способности NVLink.
- Инференс LLM — благодаря поддержке FP8 и большому объёму памяти.
- Компьютерное зрение и обработка изображений.
- Научные исследования — биоинформатика, финансовое моделирование, климатология.
Система особенно актуальна для организаций в регионах, где поставки H100 ограничены, но требуется близкая к флагманской производительность.
Стоимость и доступность
Цены на DGX H800 существенно варьируются в зависимости от канала поставки. Аренда одного узла (8 GPU) в Гонконге составляет около 320 000 гонконгских долларов в месяц. На материковом Китае облачные ресурсы H800 предлагаются примерно за 68 000 юаней в месяц за карту, а почасовая аренда — от 10 до 11 юаней за карту-час. Покупка сервера у сторонних поставщиков обходится примерно в 616 000–745 000 евро.
Важно
NVIDIA DGX H800 — это компромиссное решение, сохраняющее вычислительную мощь архитектуры Hopper, но с ограничениями по межсоединениям, наложенными экспортным контролем. Для задач, где доминируют вычисления, а не обмен данными между GPU, он остаётся высокоэффективной платформой. Однако при обучении моделей с интенсивным tensor-параллелизмом разрыв с DGX H100 может быть заметным. Выбор в пользу H800 оправдан в условиях ограниченного доступа к H100 или при развёртывании инференс-систем, где узкое место — не NVLink, а пропускная способность памяти или вычислительные блоки.
Мы делимся этой технической информацией, чтобы помочь вам в выборе — используйте её с пониманием. Статья носит рекомендательный характер.